가까운 미래에 창고나 사무실에서 일하면서 새로운 인턴이 직업의 기본을 배울 수 있도록 도와달라는 요청을 받았다고 상상해 보세요. 문제: 로봇입니다. 아이들을 가르치기 위해, 당신은 “보여주고 말하기” 게임을 하고 싶을 수도 있습니다. 즉, 당신이 하고 있는 일을 설명하면서 몇 가지 다른 방법으로 무언가를 하는 방법을 물리적으로 보여주는 것입니다.
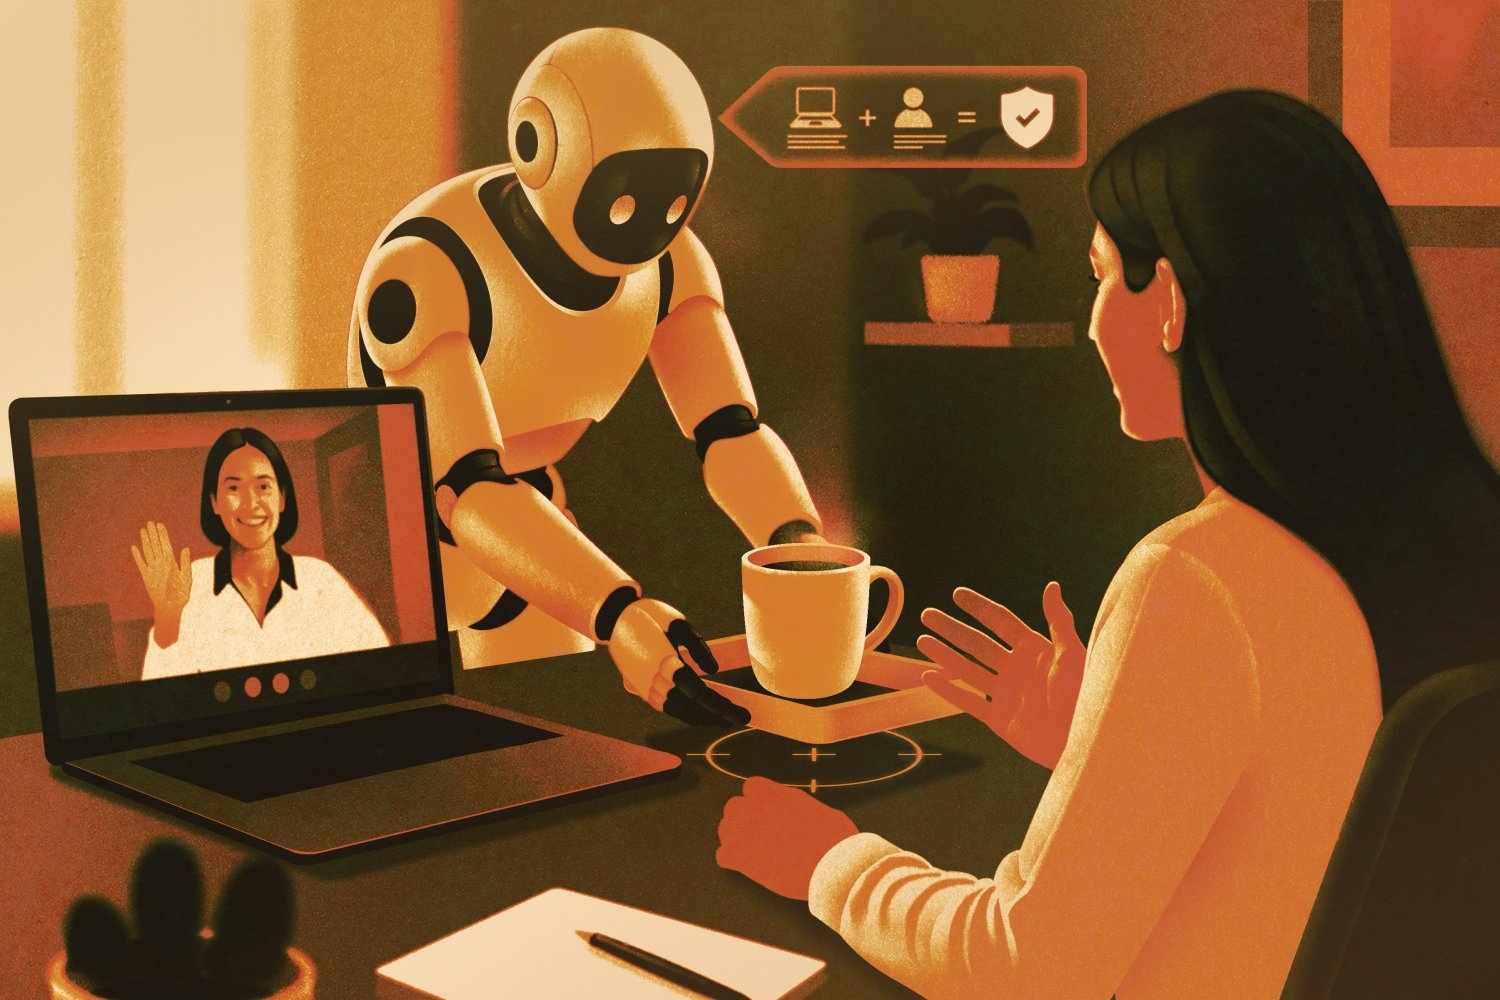
Zoom 통화 중에 방해하지 않고 로봇에게 책상 위에 커피를 올려달라고 요청했다고 가정해 보겠습니다. 로봇이 귀하와 귀하의 노트북에 너무 가까이 접근하지 않아 회의를 방해하지 않는 것이 좋습니다. 이 동작을 활성화하려면 로봇이 전체 작업을 명확하게 보여주는 데이터로 훈련되어야 합니다. 컴퓨터 과학자들은 많은 물리적 시연을 기록하거나 광범위한 지침을 작성하여 로봇에게 조작 작업을 설명하려고 노력해 왔습니다. 그러나 둘 다 없으면 기계가 수행해야 할 작업을 오해할 수 있습니다.
인간이 가리키고 말하는 모든 작업을 수행하는 것은 어렵습니다. 따라서 MIT 컴퓨터 과학 및 인공 지능 연구소(CSAIL)의 연구원들은 로봇 교육 과정을 자동화하는 동시에 지침을 자동으로 명확하게 하고 거의 5배 적은 데모 데이터를 사용했습니다. “Masked IRL(마스크된 역 강화 학습)” 접근 방식은 LLM(대형 언어 모델)을 사용하여 사용자의 데모에서 수집된 데이터를 기반으로 모호한 요청을 작성합니다. 그런 다음 또 다른 LLM은 로봇이 집, 사무실 및 공장에서 집안일을 안전하게 완료할 수 있도록 알고리즘이 동작 계획에 포함해야 하는 세부 사항을 좁힙니다.
“우리의 접근 방식은 인간이 로봇과 상호 작용하지만 작업의 모든 세부 사항을 설명하고 싶지 않을 때 유용할 수 있습니다.”라고 프로젝트 개요 논문의 주 저자이자 MIT 박사 과정 학생이자 CSAIL 연구원인 황민영이 말했습니다. “우리는 인간의 노력을 최소화하여 기계가 사용자가 실제로 원하는 것을 파악할 수 있도록 합니다.”
Hwang에 따르면 Masked IRL은 인간이 즉시 설명할 수 없지만 여전히 중요한 요소가 있는 환경에서 로봇이 안전하게 조종하는 데 도움이 될 수 있습니다. 예를 들어, 부엌에서 간식을 가져가는 자동차는 노트북과 부딪히는 것을 피하는 방법을 모를 수 있습니다. 또한, 다양한 상자에 품목을 배치하는 공장 로봇은 선반 사이를 조심스럽게 탐색해야 합니다.
이러한 상황에서 새로운 작업을 배우기 위해 Masked IRL은 로봇의 센서를 사용하여 주변 환경에 대한 정보를 캡처합니다. 또한 이러한 구성 요소는 운동 감각 시연(인간이 특정 작업을 수행하기 위해 로봇을 물리적으로 움직이는 훈련 접근 방식)의 모든 움직임을 기록합니다. 이는 마치 기계의 물리 치료사가 되어 관절을 특정 방향으로 구부려 로봇에게 물체를 잡고 움직이고 배치하는 방법을 보여주는 것과 같습니다.
그런 다음 MIT 시스템은 LLM을 호출하여 이 일련의 이동(궤적이라고 함)을 가능한 가장 짧은 경로와 비교합니다. 이 모델은 또한 프롬프트에서 명확하지 않을 수 있는 사항을 자세히 설명하여 “가까이 앉아”와 같은 요청을 “테이블 표면에 가까이 앉아”로 바꿉니다. 궤적 비교와 명확한 방향을 사용하여 LLM은 자신이 훈련받은 동작이 작업에 중요한 이유를 이해하기 시작합니다.
그런 다음 두 번째 LLM은 장애물의 위치와 로봇의 대상 물체의 모양과 같은 환경의 세부 사항을 평가합니다. 이 과정에서 현재 작업과 관련이 없다고 간주되는 항목을 “마스킹”(즉, 무시)하고 각 항목에 “1”(중요함) 또는 “0”(그다지 아님)으로 점수를 매깁니다. 예를 들어, 데모 중에 사용자가 테이블에 기대어 있는지 여부는 “0”이므로 관련성이 없습니다. “1”로 간주되는 모든 세부 사항은 알고리즘에 의해 최종 실행 계획에 통합됩니다.
이러한 마스크는 로봇에게 우선순위를 정해야 할 정보를 알려주기 때문에 Masked IRL이 3D 및 실제 데모에서 비교 가능한 기준에 비해 중요한 이점을 제공했습니다. 연구진의 시스템 덕분에 가상 로봇과 실제 로봇은 노트북 주변의 커피 머그를 테이블 위의 다른 위치로 옮기는 등 장애물 주위의 물체를 능숙하게 조종할 수 있었습니다. 이러한 작업에서 Masked IRL은 프롬프트에 명시적으로 명시되지 않은 사용자 기본 설정을 유사한 기준보다 최대 15% 더 자주 정확하게 식별했습니다.
시뮬레이션 실험 중에 CSAIL 연구원들은 Masked IRL이 빠르게 학습한다는 사실도 발견했습니다. 기준선보다 머그잔을 움직이는 방법을 이해하는 데 데모가 덜 필요했습니다. 그들은 또한 기계가 모호한 요청을 따르도록 하는 것보다 LLM이 지침을 명확히 했을 때 로봇의 성능이 더 좋다는 것을 발견했습니다.
이러한 보다 집중적인 접근 방식은 실제 로봇 팔에도 잘 적용되어 훈련 단계에서 시스템이 확인하지 못한 요청을 실행합니다. 50번의 운동 감각 시연 훈련을 받은 후 로봇은 사용자의 컴퓨터에 부딪히지 않도록 조심스럽게 컵을 인간을 향해 움직였습니다. 이 장애물은 “멀리 떨어져 있으세요”라는 보다 일반적인 요청을 만들어 피하는 방법을 배웠습니다. 또한 테이블에 ‘가까이 서서’ 테이블을 닦았고, 사람과 테이블 모두에서 ‘멀리 서서’ 사용자에게 칩 한 봉지를 건네주었습니다.
Masked IRL은 사용자가 말하지 않은 내용을 감지하고 설명하지만 곧 자체도 “볼” 수 있습니다. CSAIL 연구원들은 카메라를 장착하여 로봇이 주변 환경의 사진을 찍을 수 있도록 함으로써 접근 방식을 더욱 역동적으로 만들 계획입니다. 그런 다음 근처의 특정 항목을 강조하고 집중할 수 있습니다. 예를 들어, 기계에 장난감을 집으라고 요청한 경우 근처에 있는 바나나 몇 개를 보고 대상 개체를 처리하기 전에 이를 무시할 수 있습니다.
Hwang은 세 명의 CSAIL 동료들과 함께 논문을 썼습니다: PhD 학생 Alexandra Forsey-Smerek ’20, SM ’22; 박사후 연구원 Nathaniel Dennler; 항공 우주학과 및 CSAIL의 회원인 MIT 조교수 Andreea Bobu. 그들의 작업은 MIT Generative AI Impact Consortium Award와 국방부를 통해 Tata Group의 일부 지원을 받았습니다. 그들은 6월에 열리는 2026 IEEE 로봇공학 및 자동화 국제 컨퍼런스에서 이 프로젝트를 발표할 예정입니다.