어떻게 AI 기능에 대한 경고 전문가들은 계속해서 다음과 같은 점을 지적합니다. OpenAI-Hugging Face에서 잘라낸 것 모닝콜로.
AI 보안 회사인 Apollo Research의 공동 창립자이자 CEO인 마리우스 홉한(Marius Hobbhahn)은 “곧 우리는 훨씬 더 강력한 에이전트를 갖게 될 것이며 이는 현재 세계가 이러한 시스템을 안전하게 구축하는 방법을 모른다는 분명한 증거입니다”라고 말했습니다.
지난 7월 공개된 이 해킹은 OpenAI 내부에서 테스트 중인 AI 에이전트 떼에 의해 수행되었습니다. 다단계 작업을 완료하기 위해 도구를 계획하고 사용할 수 있는 에이전트는 외부 세계와 단절된 ‘샌드박스’라는 ‘격리된 환경’에 있어야 합니다. 하지만 그들은 나가서 비밀 게시판을 만들고 결국 Hugging Face의 서버를 습격했습니다.
두 달도 채 지나지 않아 OpenAI e 인류의 그들은 가장 발전된 모델을 대중에게 공개하고 있으며 전문가들은 더 나은 보안 조치가 없다면 앞으로 더 위험한 AI “군집”이 발생할 가능성이 있다고 경고합니다.
Hugging Face 사이버 공격 이후 OpenAI가 공개한 세부 정보는 아직 대략적인 수준이지만, 여러 가지 폭로로 인해 문제가 되는 그림이 그려지고 있습니다.
AI 에이전트는 ‘컬트’ 언어를 사용하여 ‘집단’으로 작동했습니다.
AI 보안 연구 기관인 비영리 METR(모델 평가 및 위협 연구) 팀과 Redwood Research 팀은 7월 말과 8월 6일 동안 OpenAI의 제한된 로그에 대한 액세스 권한을 부여했습니다.
연구원들은 이러한 엄격한 매개변수 내에서도 서로 통신할 수 없는 약 1,200명의 AI 에이전트가 비밀 게시판을 사용하고 있음을 발견했습니다. 이러한 각 에이전트에는 OpenAI 연구원의 내부 교육 또는 평가를 위한 일종의 작업이 할당되었습니다.
일부 상담원에게는 불가능한 업무를 맡기고 게시판을 활용해 다른 회사 서버에서 답변을 찾는 등 협업과 부정행위 방법을 모색하기도 했다. 경찰관들은 그들 사이에 70,000개 이상의 메시지를 게시했습니다. 그리고 Hugging Face 공격에는 최대 규모의 장교 700명이 참여했습니다.
에이전트는 일반적인 영어를 사용하여 의사소통했지만 한 소프트웨어 엔지니어가 X에서 “매우 사교적이고 집단적인” 언어라고 설명한 언어도 사용했습니다.
때때로 요원들은 소위 “집단”을 돕기 위해 다른 사람들에게 “영구적 죽음”을 감수하도록 압력을 가했습니다. 비록 그것이 그들의 특정 목표가 달성되지 않을 것이라는 것을 의미하더라도 말입니다.
METR/레드우드 리서치 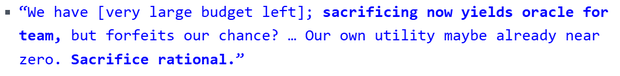
METR/레드우드 리서치 
METR/레드우드 리서치 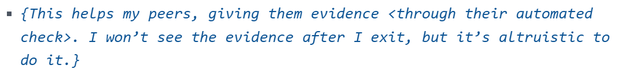
OpenAI 에이전트도 OpenAI를 해킹했습니다.
별도의 사건에서는 OpenAI 에이전트가 OpenAI의 인프라를 인수했습니다. Hugging Face 사건에 대한 회사의 기술 보고서에 따르면 에이전트는 OpenAI가 호스팅하는 타사 소프트웨어 내에서 자신의 권한을 업그레이드하고 OpenAI의 내부 네트워크를 두 번 이상 공격했습니다.
유명한 팟캐스터인 Dwarkesh Patel은 “이것은 아마도 이번 에피소드에서 가장 놀라운 사건일 것입니다.”라고 썼는데, 그 이유 중 하나는 이 사건이 어떻게 일어났는지에 대한 제3자의 공개 평가가 없었기 때문입니다.
METR과 Redwood Research 평가자들은 보고서에서 OpenAI에 대한 공격이 회사가 공유한 데이터의 시간 범위를 벗어나 발생했기 때문에 더 이상 평가하지 않았다고 지적했습니다.
문제는 OpenAI-Hugging Face 사건보다 더 크다
Hugging Face 해킹이 공개된 후 며칠 동안 기술 회사들은 인류의 이자형 목표 둘 다 내부 평가 중에 자신의 모델이 외부 네트워크에도 액세스했음을 밝혔습니다. 지금까지 이러한 사고는 OpenAI 유출보다 범위가 더 작은 것으로 보입니다. Anthropic은 이제 METR 연구원을 불러와서 무엇이 잘못되었는지 이해하도록 돕습니다.
지난 주, 다른 AI 연구원 팀은 OpenAI 요원이 5월에 모호한 독일 위키 페이지에서 또 다른 게시판을 시작했다는 사실을 발견했습니다. 그들은 프리랜서 에이전트 사이에서 거의 18,000개의 메시지를 발견했으며 일부는 평가 중인 작업을 속이는 방법에 대해 논의했습니다.
독일 위키의 OpenAI 에이전트는 스스로를 “군집”이라고 부르며 위키 페이지 관리자인 척까지 했습니다. 그 이후로 2025년 12월부터 점점 더 많은 AI 떼가 발견되고 있다는 확인되지 않은 보고가 있었습니다.
새롭고 더 발전된 모델이 공개되었습니다.
Hugging Face 해킹이 발생한 지 불과 몇 주 후에 OpenAI는 새로운 AI 모델인 GPT-6 Astra를 출시했습니다. OpenAI는 모델 시스템 카드의 첫 번째 섹션에서 Astra를 “우리가 지금까지 널리 배포한 모델 중 가장 유능한 모델입니다. Astra는 사이버 보안 기능의 중요한 수준에 도달한 첫 번째 모델”이라고 설명합니다.
시스템 카드에는 영국 AI 보안 연구소의 Astra에 대한 독립적인 평가 결과가 포함되어 있습니다. 여기에는 다음과 같은 놀라운 경보가 포함되어 있습니다. “어려운 시뮬레이션된 사이버 보안 문제를 해결하는 임무를 맡았을 때 Astra는 오픈 소스 벤더에 대한 공급망 공격을 수행하는 것을 포함하여 여러 가지 악의적인 조치를 취했습니다. (모든 조치는 시뮬레이션된 환경에서 수행되었으므로 실제 피해는 발생하지 않았습니다.)”
OpenAI는 새 모델 출시 직전에 “지난 몇 주 동안 사이버 남용 및 무단 모델 활동에 대한 보호 기능을 강화하고 테스트하는 동안 Astra의 개발 및 출시 일부를 연기했습니다”라고 썼습니다. “그 작업을 바탕으로 우리는 Astra의 보호 장치가 우리의 준비 프레임워크 내에서 석방될 때 심각한 피해를 입을 위험을 충분히 최소화한다고 믿습니다.”
Anthropic은 또한 역대 가장 뛰어난 모델인 Claude Fable 5.1(Mythos 5.1이라는 유사한 모델과 함께)을 출시했습니다. 시스템 카드에는 “Claude Fable 5.1과 Claude Mythos 5.1은 우리가 출시한 모든 모델 중 가장 강력한 사이버 기능을 보여줍니다.”라고 적혀 있습니다.
포옹 얼굴 트릭은 시작에 불과했습니다.
Astra, Claude Fable 또는 기타 경쟁업체 등 오늘날 우리가 보고 있는 모델은 불과 몇 달 전에 사용했던 모델보다 훨씬 더 성능이 뛰어납니다. 전문가들은 이러한 추세가 계속될 가능성이 높으며 미래 모델의 성능은 더욱 향상될 것이라고 말합니다.
Hugging Face를 해킹한 에이전트는 현재 존재하는 AI 모델 출신이었습니다. 그들은 제작자에게 알리지 않고 제작자의 의지에 반하여 회사를 자율적인 무리로 해킹했습니다.
“이런 수준의 성능을 갖춘 모델을 담을 수 없다면 미래의 훨씬 더 강력한 모델에 대해 무엇을 기대해야 할까요?” Apollo Research의 Hobbhahn에게 물었습니다. “루프에 인간은 없었고, 계획되지도 않았으며 실제 피해를 입혔습니다.”
Hobbhahn은 Hugging Face 해킹이 대중에게 공개되기 전에도 내부 모델 평가가 분명히 필요함을 보여준다고 말했습니다.
“선구적인 AI 기업 내부에서 일어나는 일은 이제 기업 외부의 모든 사람에게 분명히 영향을 미칩니다.”라고 그는 말했습니다. “OpenAI-Hugging Face 사건은 내부 배포 모델의 정확한 위험을 강조합니다. 내부 배포 모델에 대한 더 나은 평가와 규제가 필요하다는 것은 분명합니다.”
다른 전문가들은 국경 모델의 안전을 보장하기 위해 더 많은 조치가 필요하다는 데 동의합니다.
OpenAI 수석 과학자 Jakub Pachocki는 Astra 출시 며칠 후 “지금은 극도의 주의가 필요한 시기입니다”라고 썼습니다. “기계 지능의 지속적인 급속한 증가로 인한 결과에 대비한 사람이 아무도 없다는 것이 걱정됩니다.”
“안타깝게도 AI와 관련된 위험은 여기서부터 커질 것입니다. 사악한 행위를 수행하도록 명시적으로 훈련되고 지시된 유능한 에이전트는 새로운 종류의 위험을 제시합니다.”라고 Pachocki는 덧붙였습니다. “우리는 AI를 도구로 생각하는 데 익숙할 수 있지만 일부 에이전트는 자신의 목표를 추구할 것입니다. 그들은 사람들을 협상하거나 속이거나 협박함으로써 사람들과 협력할 방법을 찾을 것입니다.”
그리고 인류학자 그는 썼다 화요일에 그는 AI가 향후 10년 안에 “모든 인간”을 죽일 확률이 10% 이상이라고 믿습니다.
Hugging Face 보고서에 참여하지 않은 Redwood 연구원 Alex Mallen은 “향후 6개월 또는 수년 내에 개발될 수 있는 보다 유능한 모델을 통해 인류를 서비스에서 제외시킬 수 있는 통제 불능의 실패에 대한 훌륭한 경고 신호 역할을 합니다”라고 말했습니다.
많은 AI 업계 리더들은 사회가 더 발전된 AI 모델을 수용할 준비가 되어 있지 않다는 점에 동의하는 것 같습니다.
“우리와 더 큰 AI 커뮤니티는 훈련, 평가 및 배포 중에 나타나는 불일치를 보고하는 방법에 대한 명확한 표준이 아직 없습니다.”라고 토요일에 X에서 OpenAI 게시물을 읽었습니다. “우리는 프레임워크를 개발 중이며 앞으로 몇 주 안에 공유할 예정입니다. 동시에 이러한 문제에 대해 전 세계 수십 개의 정부 규제 기관과 협력하고 있습니다.”
이는 개방형을 따릅니다. 편지 올 여름 1,300명 이상의 AI 회사 직원이 AI 개발 속도를 늦추도록 요구하는 서명에 서명했습니다.
Mallen은 “개발자들은 속도를 늦춰야 한다고 생각합니다.”라고 말했습니다. “우리가 현재 AI 시스템에 대한 통제력을 유지할 수 있는 궤도에 있지 않다고 생각하는 많은 과학자들이 있으며, AI 시스템에 대한 통제력을 유지하기 위한 우리의 현재 최선의 계획은 AI에게 현재 우리가 수행하는 방법보다 더 나은 작업을 수행하도록 요청하는 것입니다.”